사용자의 문서 분류 및 검토
방대한 양의 문서 중 관련 있는 일부 문서를 검토하며 찾고자 하는 문서를 구분합니다.
사이트가 리뉴얼되었습니다.
Data Analytics
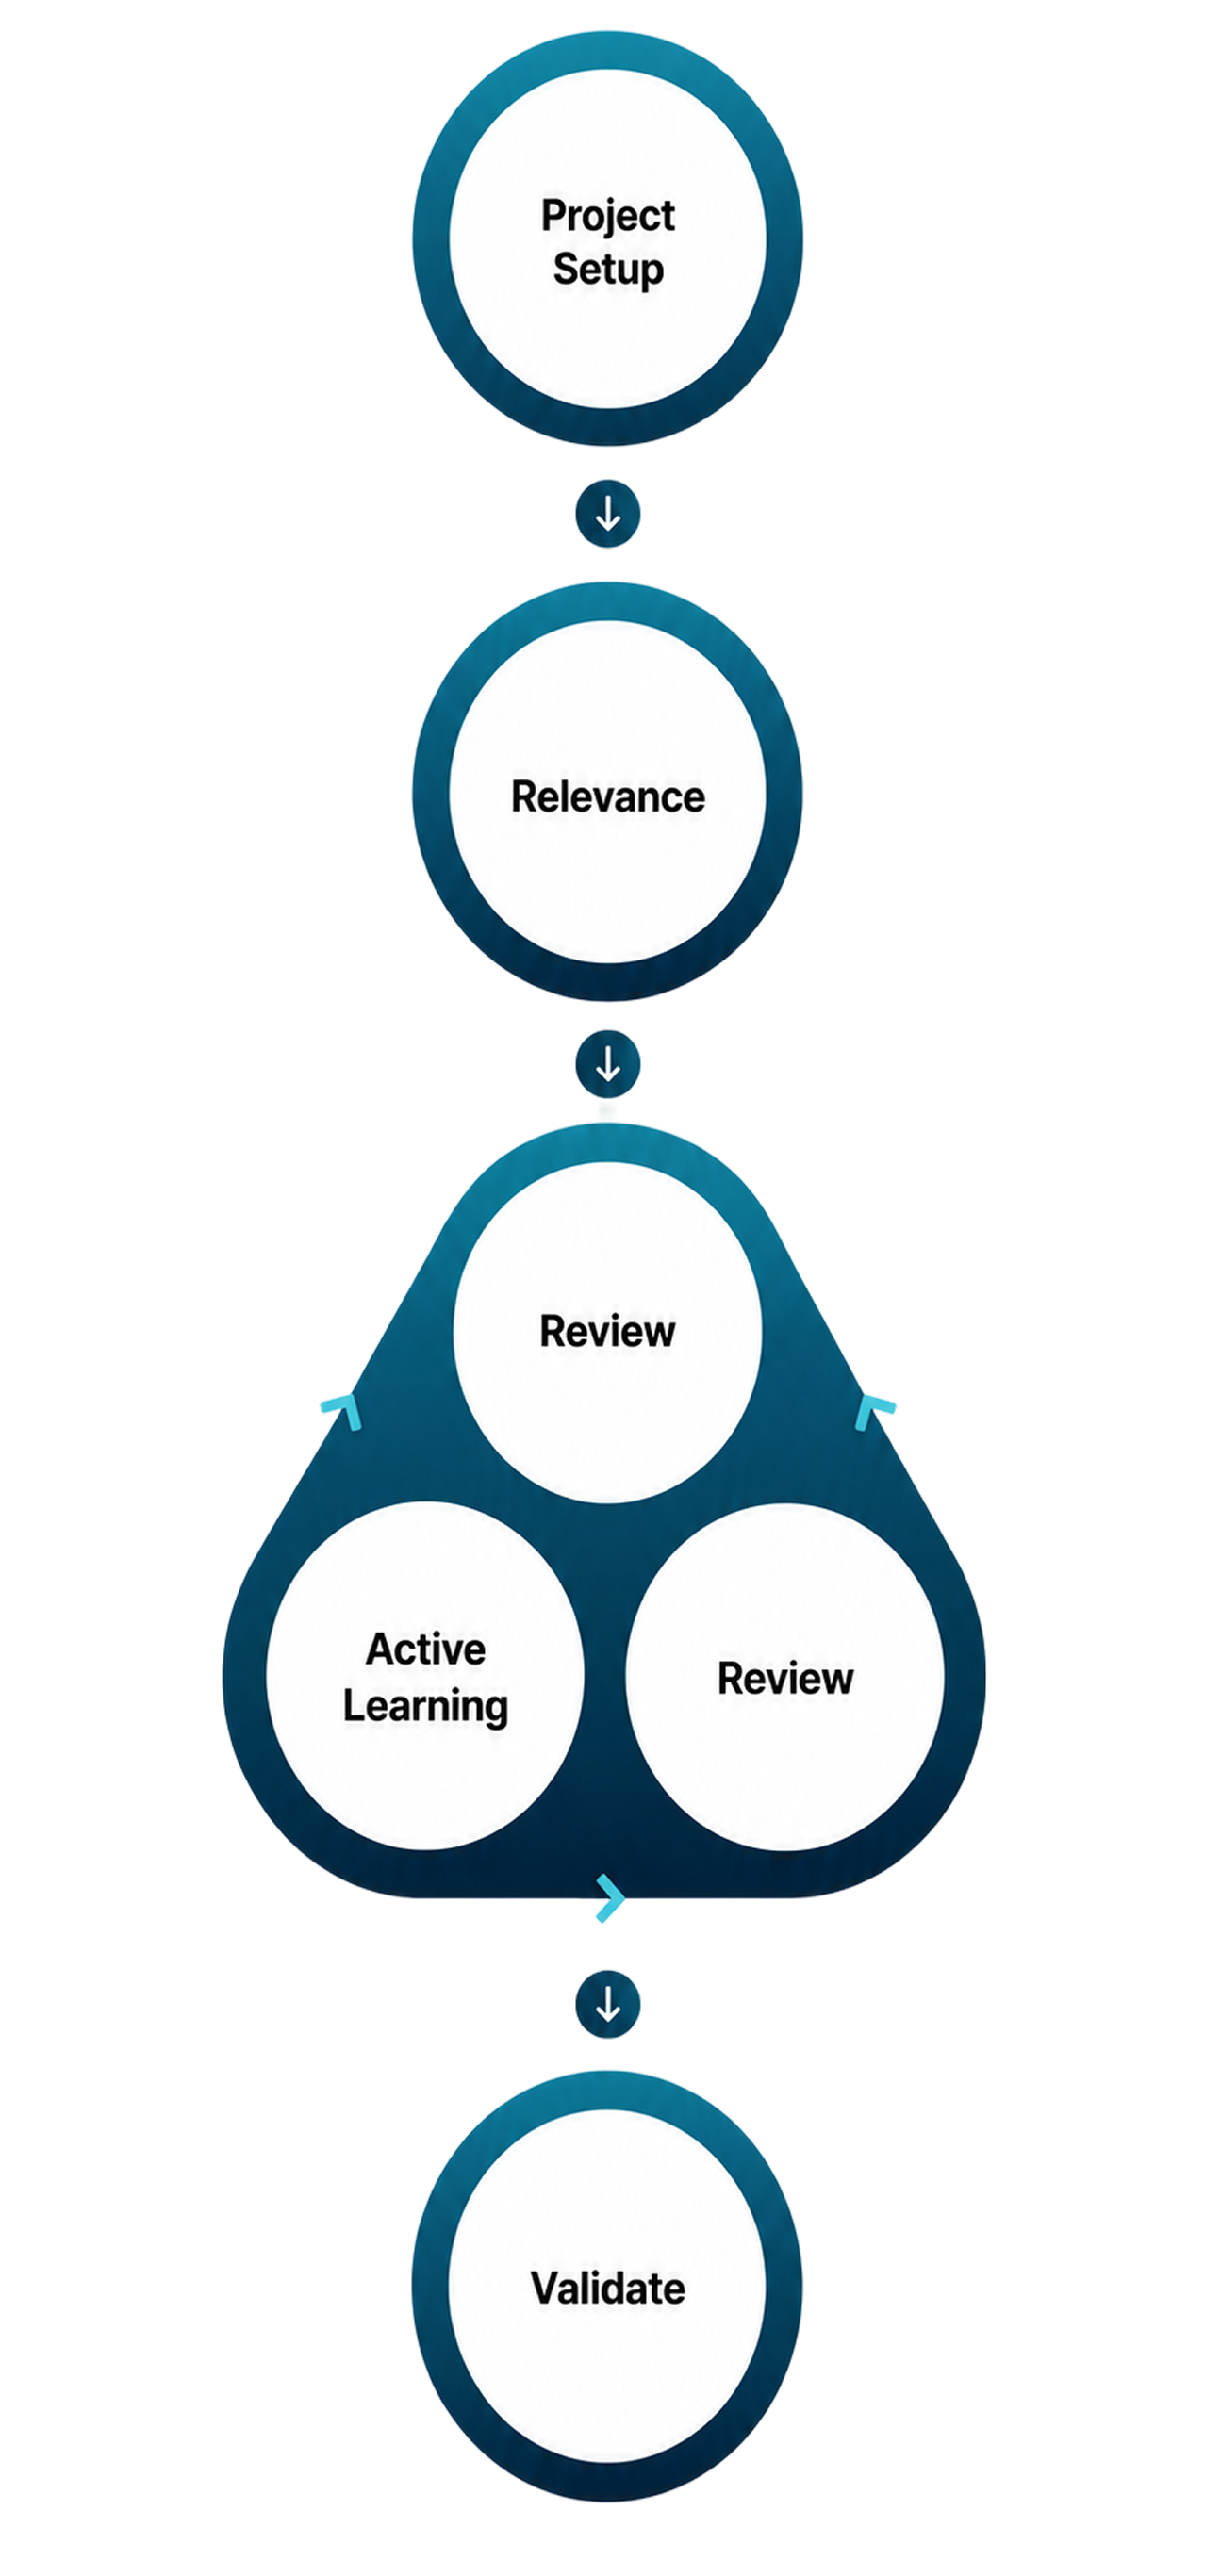
Active Learning은 머신러닝의 특별한 기법으로 AI가 학습을 시켜주는 사용자(Human Reviewer)와 소통하여 보다 능동적인 방식으로 의사 결정 기준점을 찾아가는 기법입니다. 결과의 불확실성을 최소화시키며 관련도 선별 정확도를 높여, 정확한 결괏값을 빠르게 도출하는 효과가 있습니다.
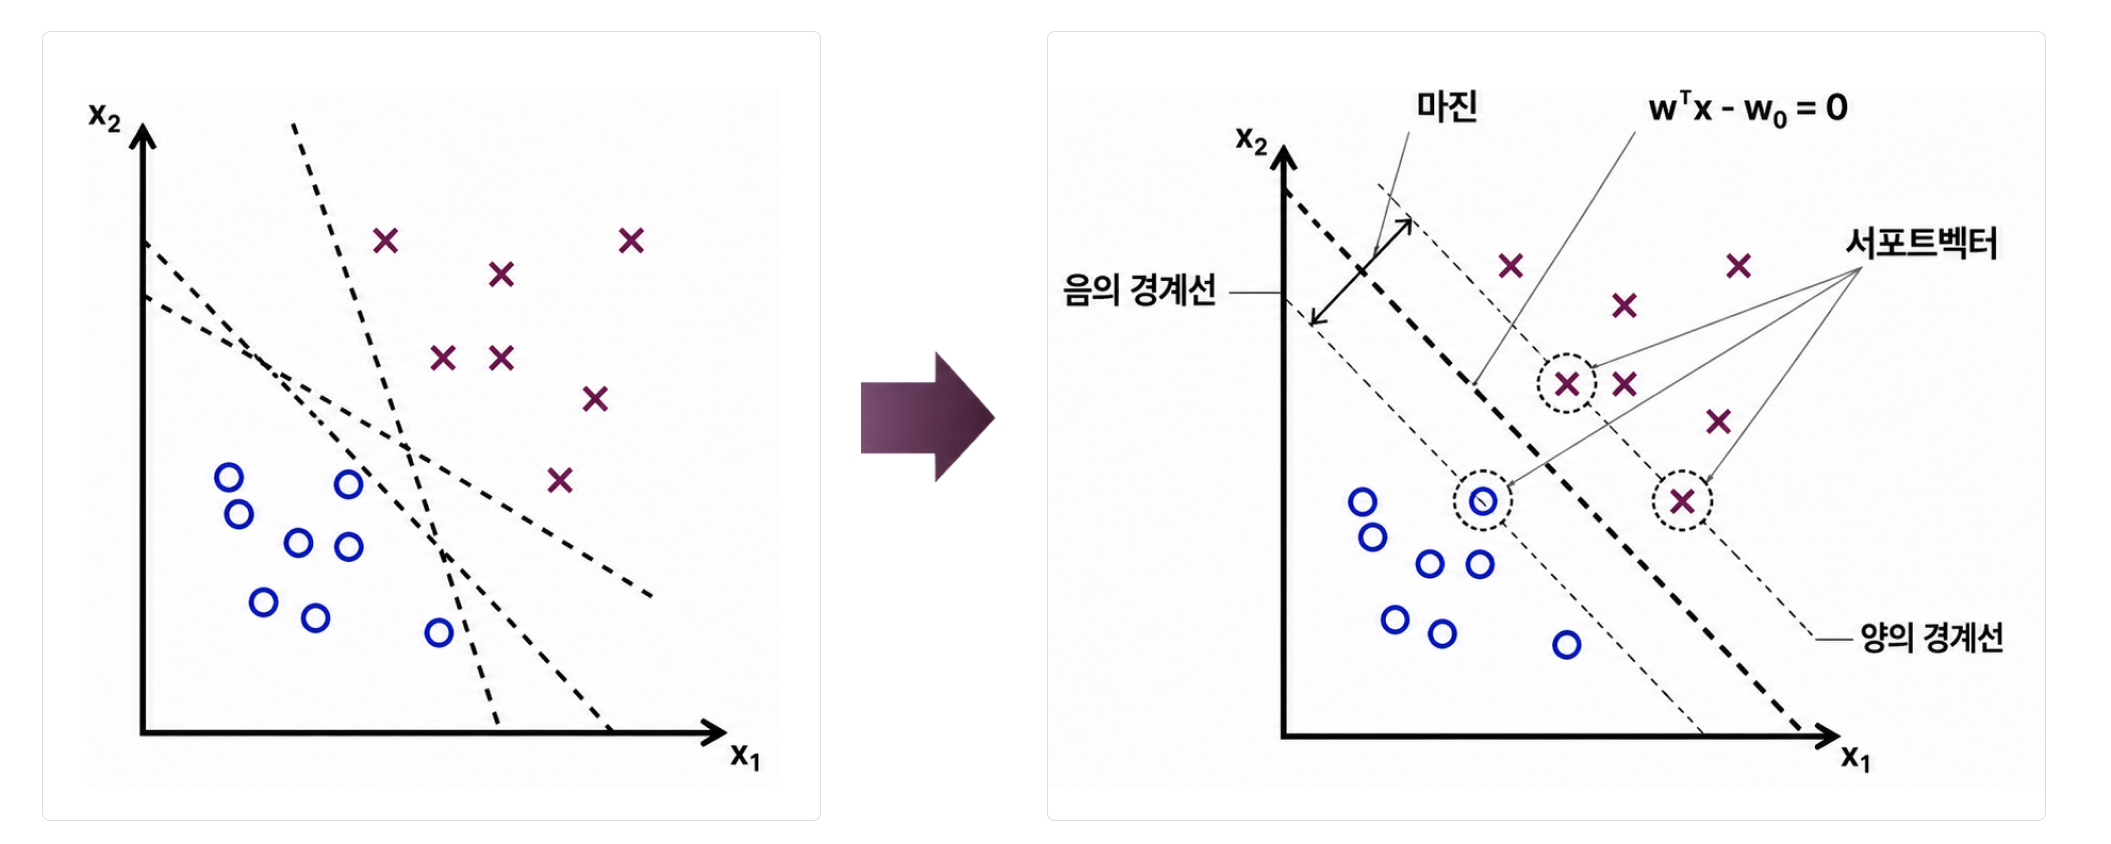
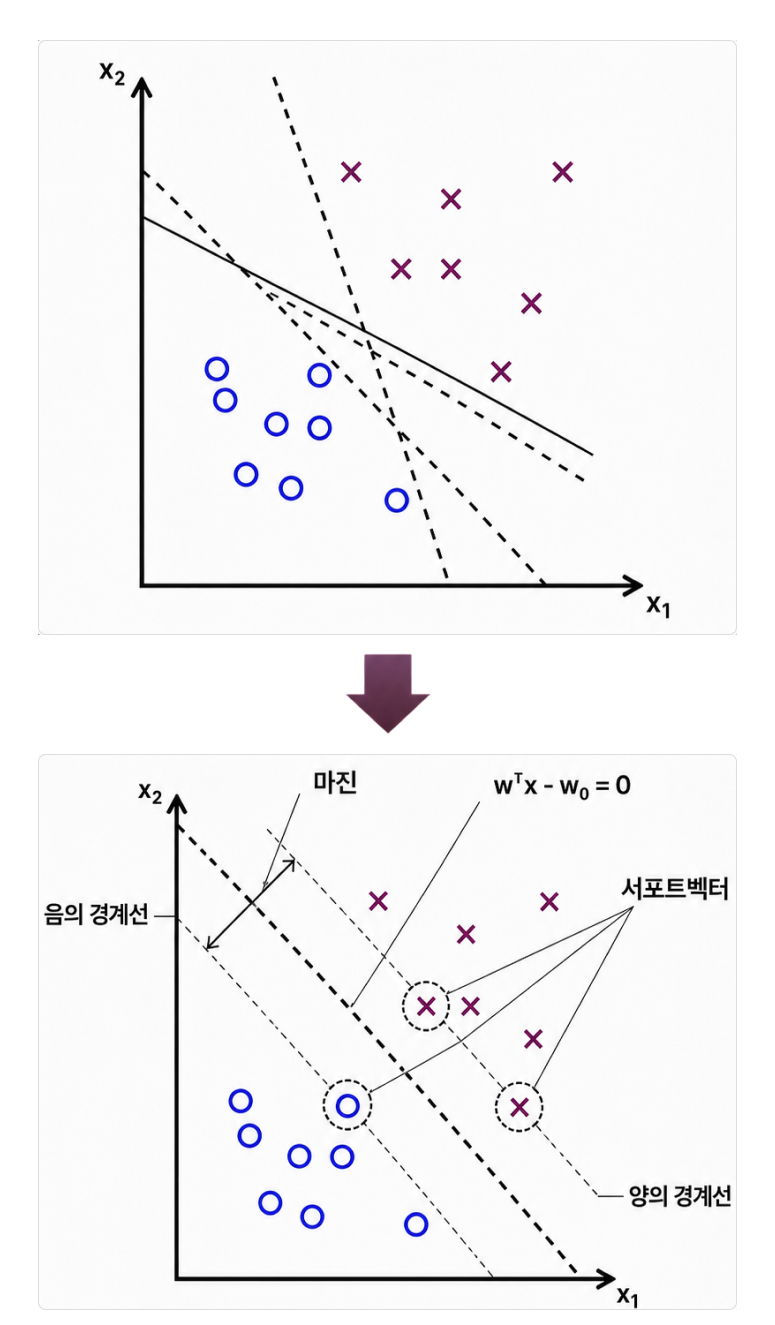
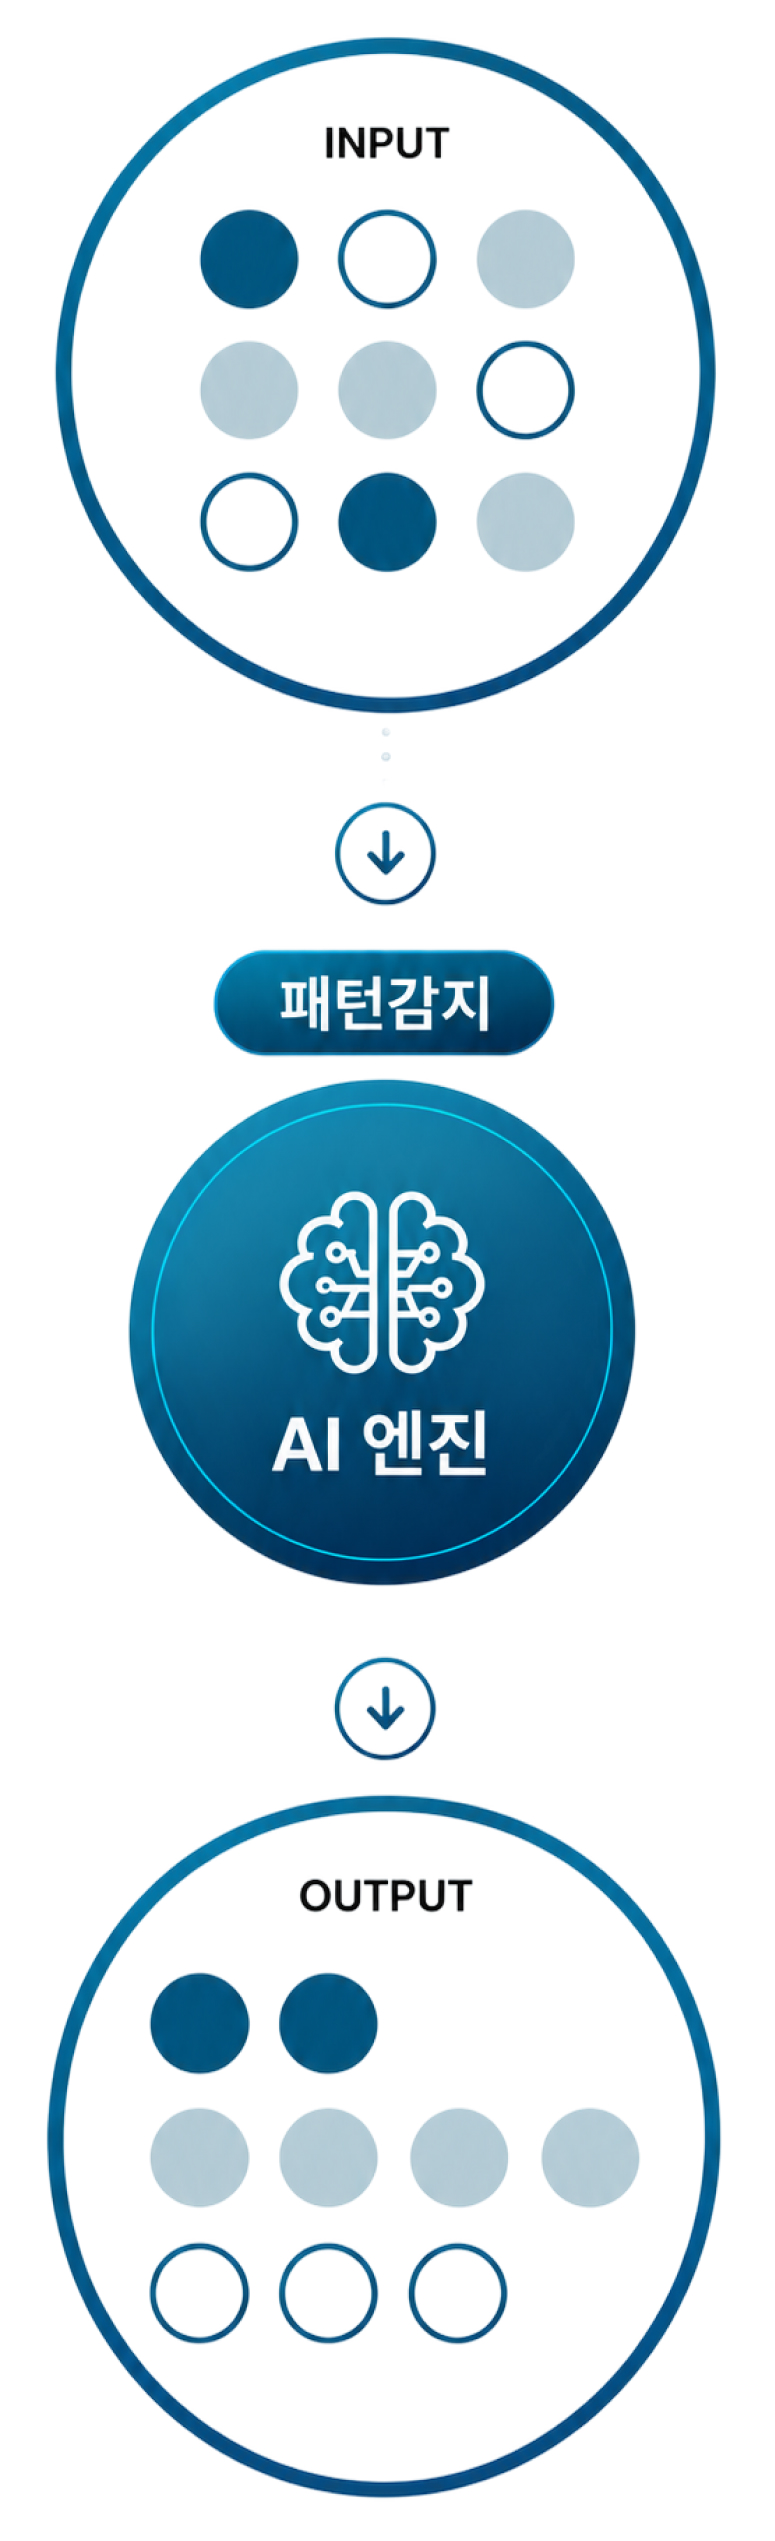
주어진 데이터가 어느 범주에 속하는지 판단하는 Binary Classification 모델로서 머신러닝 테크닉 중 한 종류입니다. 트레이닝 데이터가 패턴 인식 후 두 그룹의 가장자리(서포트 벡터)의 경계를 토대로 의사 결정을 실행하며, 해당 경계가 모호할 때 시스템이 능동적으로 기준을 찾는 방식입니다.
AI를 기반으로 한 문서 검토 지원 기술입니다. 사용자의 문서 검토 결과를 토대로 AI가 관련 여부를 판별하는 기준을 학습하고, 관련도가 높을 것으로 예상되는 문서를 먼저 검토할 수 있도록 지원합니다.
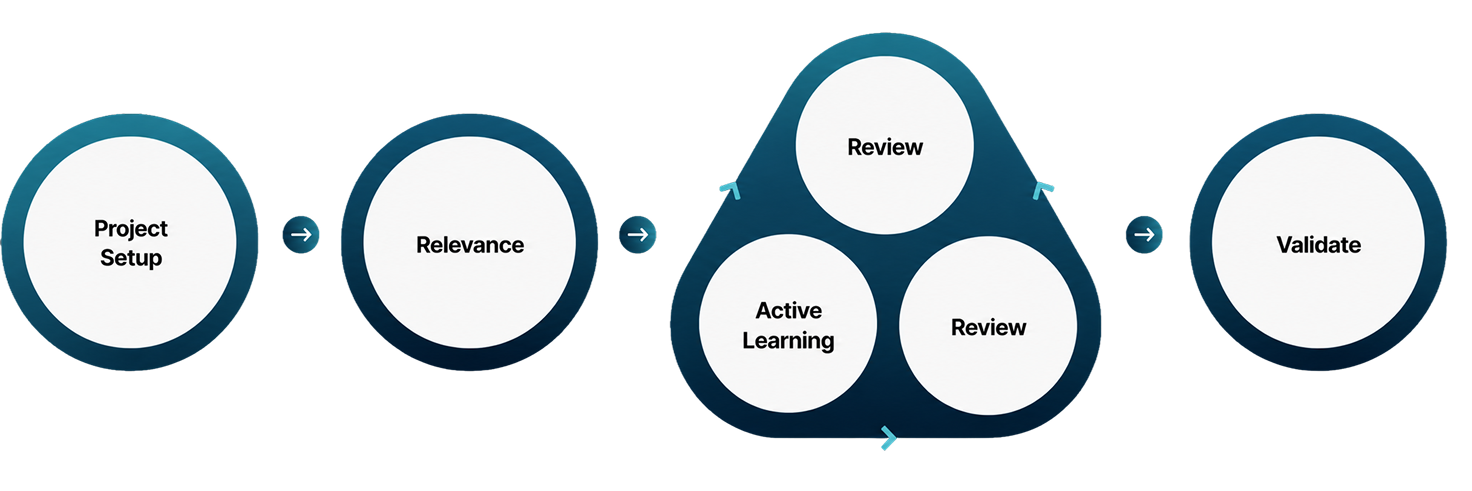
방대한 양의 문서 중 관련 있는 일부 문서를 검토하며 찾고자 하는 문서를 구분합니다.

AI는 전문가의 Insight를 기반으로 나머지 데이터에 대한 분석 및 분리를 진행합니다.

AI는 실시간 학습을 통해 사용자가 원하는 자료를 분석하여 관련도가 높은 문서를 우선적으로 검토하게 합니다.
Active Learning은 머신러닝의 특별한 기법으로 AI가 학습을 시켜주는 사용자(Human Reviewer)와 소통하여 보다 능동적인 방식으로 의사 결정 기준점을 찾아가는 기법입니다. 결과의 불확실성을 최소화시키며 관련도 선별 정확도를 높여, 정확한 결괏값을 빠르게 도출하는 효과가 있습니다.
Active Learning 기법을 통해 문서를 실시간으로 분석할 수 있으며, 사용자로 하여금 관련도가 높은 문서들을 우선적으로 리뷰할 수 있도록 지원합니다.
주어진 데이터가 어느 범주에 속하는지 판단하는 Binary Classification 모델로서 머신러닝 종류 중 하나입니다.
트레이닝 데이터 간의 패턴 인식 후 두 그룹의 가장자리(Support Vector)의 경계를 토대로 의사 결정을 실행하며, 해당 경계가 모호할 때 시스템이 능동적으로 기준을 찾는 방식입니다.
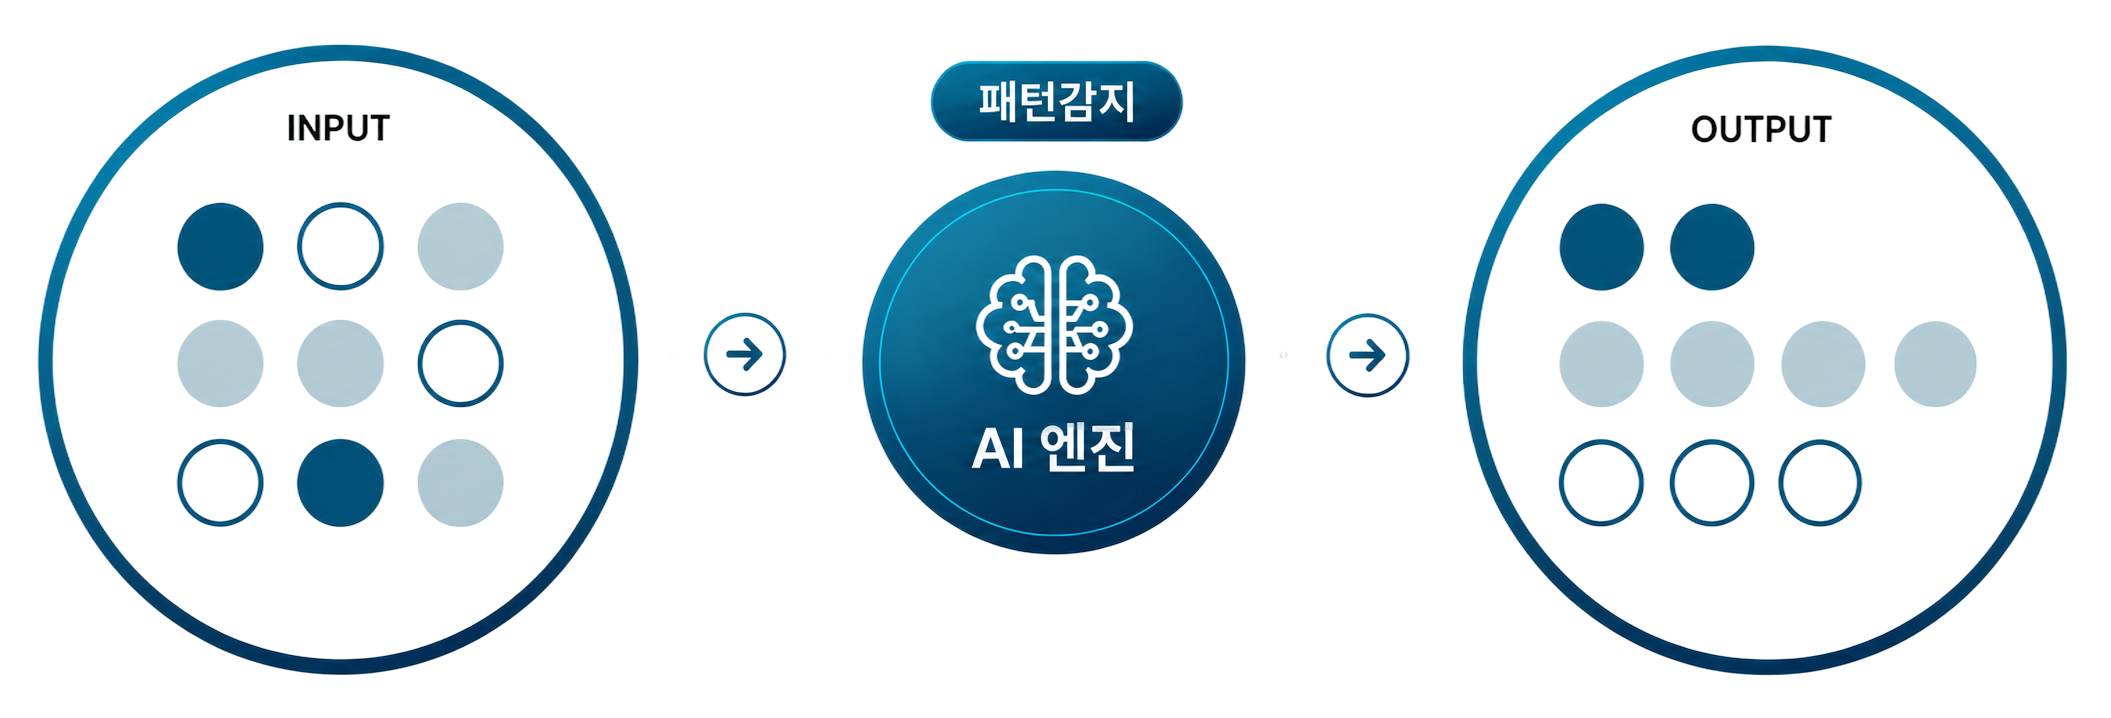
문서의 내용에 포함된 의미, 텍스트, 메타데이터 등을 분석하여 중요도 높은 내용을 찾아내거나 문서 간 유사점과 차이점을 식별하는 분석 기술입니다.
Conceptual Analytics는 문서 내용의 의미를 고려하는 분석 기법으로 단순 키워드 검색이 아닌 문서 전체의 내용을 분석하여 중요 문서를 찾아낼 수 있습니다.
비슷한 범주의 그룹으로 문서를 분류하여 많은 양의 문서를 검토할 때 효과적인 기능입니다.
키워드 검색에서 더 나아가 잘못된 키워드를 수정해 주고 새로운 키워드를 추천하여 검색합니다.
“Phillipines” 검색 시 “Philippines”로 검색
“Student” 검색 시, “Pupil” 검색
“Coke” 검색 시, “Cola” or “Soda” 검색
“Jive” 검색 시, “Jibe” 검색
Structured Analytics는 텍스트 및 메타데이터를 분석하여 같은 세트 안에 들어 있는 문서 간의 유사점과 차이점을 식별합니다.
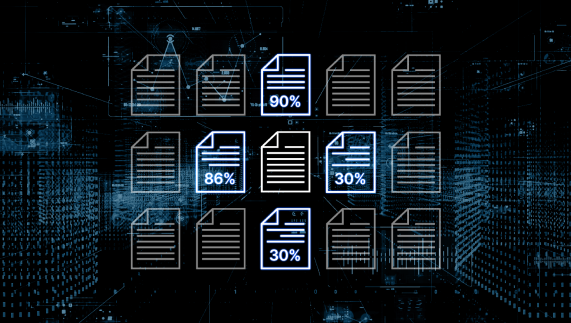
완벽하게 동일한(Identical) 문서를 식별하기도 하며, 버전 관리와 같이 동일하지는 않지만 유사한 문서들 또한 식별하여 구분할 수 있습니다.
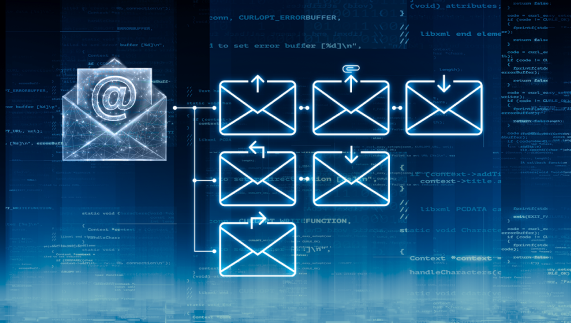
전체 답장, 답장, 전달된 모든 이메일을 하나로 모아 대화의 맥락을 빠르게 살피고, 송수신인들의 관계를 쉽게 파악할 수 있습니다.
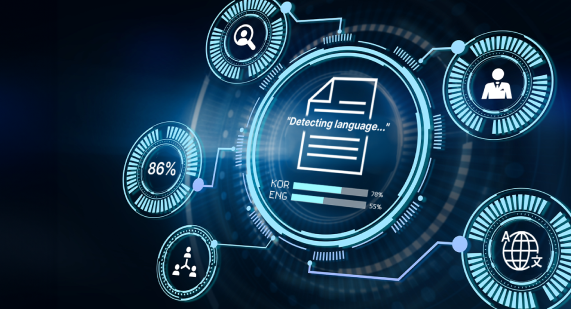
문서 작성에 사용된 언어를 감지하고, 해당 언어별로 문서를 구분할 수 있으며, 여러 개의 언어를 사용한 경우 각 언어의 사용량을 표시해 줍니다.